在补充机器学习基础的过程中,公式、训练代码和评价指标需要放在一起理解。本文主要参考 Google Machine Learning Crash Course 的线性回归、逻辑回归和分类三个模块,记录这一阶段的核心概念及对应的 PyTorch 实验。
实践从一个简单任务开始:根据学习时长、练习次数预测分数,再将任务改成预测是否通过考试。文中的数据均为教学模拟数据,结果用于说明训练和评估流程。
1. 从数据、目标和模型开始
1.1 监督学习提供了什么
监督学习同时提供输入特征和对应的真实目标:
X:学习时长、练习次数等输入信息。y:真实分数,或者“通过 / 未通过”的标签。pred:模型根据输入计算出的预测。
训练通过比较 pred 和 y,计算损失,再调整参数。监督信号来自输入与真实目标的对应关系。
预测分数属于回归,目标是连续数值;预测是否通过属于分类,目标是类别。二分类可以先预测正类的概率,再根据阈值得到类别。
1.2 几个库的分工
| 工具 | 在学习中的作用 |
|---|---|
| NumPy | 组织数值数组,理解形状、索引、广播等运算 |
| Pandas | 读取和整理表格,选择特征、目标,处理缺失值 |
| Matplotlib | 查看数据,绘制损失曲线和 ROC |
| PyTorch | 使用张量组织模型计算,自动求导并更新参数 |
对于有两个特征的 N 个样本,可以将输入组织为 (N, 2)。本篇每个样本输出一个分数或一个二分类 logit,因此目标采用 (N, 1)。这些形状是本例的安排,其他任务需要按模型和损失函数的要求组织数据。
这里的输入与目标使用浮点张量,默认是 torch.float32。从表格转入模型时,需要同时检查形状和数据类型,避免将整数或字符串直接当作模型需要的浮点输入。
1.3 model 是什么
model = nn.Linear(2, 1)
pred = model(X)
model 指向一个可调用的模型对象。nn.Linear(2, 1) 创建两个输入特征、一个输出的线性层,并管理权重、偏置和计算方法:
model.weight  # 权重,形状为 (1, 2)
model.bias # 偏置,形状为 (1,)对于这个线性层,model(X) 等价于:
pred = X @ model.weight.T + model.bias调用完成后,pred 保存的是已经算出的张量。参数后来改变时,需要再次执行前向计算,才能得到新的预测。
nn.Linear 默认随机初始化参数。训练改变这些参数;当前这个线性层在参数和输入相同时,预测结果也相同。重新执行 model = nn.Linear(...) 则会创建一个新的模型。Linear 官方说明
2. 线性回归与损失函数
2.1 从公式到批量计算
单特征线性回归可以写成:
预测值 = w × x + b两个特征时:
预测分数 = w₁ × 学习时长 + w₂ × 练习次数 + b权重控制特征在当前模型中的作用,偏置提供额外的平移量。手写计算可以使用 X @ w + b,其中 @ 是矩阵乘法。若 X 为 (N, 2),手写的列向量 w 为 (2, 1),输出就是 (N, 1)。
2.2 为什么要对误差平方
定义残差为 e = pred - y。残差为正表示预测偏高,为负表示预测偏低。
如果两个残差是 -2 和 +2,直接平均得到 0,却不能说明预测准确。均方误差 MSE 先平方,再求平均:
MSE = (1 / N) × Σ(预测值 - 真实值)²对应代码:
loss = ((pred - y) ** 2).mean()平方使正负误差都计入损失,并让较大误差在总损失中占更大比重。误差 1 与 10 相差十倍,平方损失相差一百倍。这里并非所有数值都会变大,例如 0.1² = 0.01。
几种常见度量可以放在一起比较:
| 度量 | 运算 |
|---|---|
| 绝对误差和 | Σ abs(e) |
| 平均绝对误差 MAE | (1 / N) × Σ abs(e) |
| 平方误差和 | Σ e² |
| 均方误差 MSE | (1 / N) × Σ e² |
| 均方根误差 RMSE | sqrt(MSE) |
部分教材将绝对误差和、平方误差和称为 L1、L2 损失。使用库时需要确认它采用求和还是平均;例如 PyTorch 的 nn.L1Loss() 和 nn.MSELoss() 默认均按 mean 聚合。
若目标单位是“分”,MSE 的单位是“分²”,MAE 和 RMSE 则是“分”。RMSE 衡量误差相对于零的大小,并不是残差标准差。例如残差全为 5,RMSE 是 5,残差标准差却为 0。
3. 参数怎样学出来:梯度下降
3.1 梯度表示哪一种方向
对一个参数,导数表示损失相对它的局部变化率;对多个参数,各个偏导组成梯度。
损失变化量 ≈ 参数的偏导 × 参数变化量
新参数 = 旧参数 - 学习率 × 梯度
某个参数的梯度为正,表示小幅增大它会使损失倾向于增大,因此更新时减小它;梯度为负时则相反。
梯度的正负与残差的正负不是同一个概念。 以单样本 pred = wx 为例:
L = (wx - y)²
∂L/∂w = 2(wx - y)x
梯度同时受到残差和输入的影响。反向传播沿计算关系把各段变化率连接起来,这就是链式法则的作用。
对本篇按样本取平均的 MSE,参数梯度也是各样本梯度贡献的平均。不同样本可能提出相反的调整方向,最终通过平均得到当前更新方向。
3.2 自动求导与优化器各自负责什么
optimizer.zero_grad()
pred = model(X)
loss = loss_fn(pred, y)
loss.backward()
optimizer.step()| 操作 | 职责 |
|---|---|
model(X) |
用当前参数执行前向计算 |
loss_fn(pred, y) |
计算预测与目标的差异 |
loss.backward() |
计算损失对相关张量的梯度 |
optimizer.step() |
按优化规则读取梯度、更新所管理的参数 |
optimizer.zero_grad() |
清除所管理参数上保存的旧梯度 |
优化器持有参数的引用、学习率等设置,以及算法需要的状态;梯度保存在参数的 .grad 中。backward() 可以独立于优化器执行。
PyTorch 默认累加梯度。如果上一轮保存的是 -2,本轮新梯度为 +1,不清理就会得到 -1。当前训练每批更新一次,因此每批开始先清除旧梯度。旧梯度不会直接进入下一次前向计算,而是通过梯度累加影响后续参数更新。
中间值也参与反传。默认情况下,相关且需要求导的叶子张量会保存 .grad,中间张量通常不保留这个属性中的梯度;需要查看中间梯度时可使用 retain_grad()。自动求导与梯度保存
3.3 学习率、轮数和批次大小
权重、偏置是模型参数;学习率 lr、训练轮数 epoch、批次大小 batch_size 是控制训练过程的超参数。
- 学习率较小,更新通常更平稳,但下降可能较慢。
- 学习率合适时,可以较快降低损失。
- 学习率过大,可能跨过低损失区域,引起震荡或发散。
在本篇三样本回归实验中,固定初始化、全批量训练 1,000 轮,lr=0.001 的训练 MSE 约为 151.69,lr=0.005 约为 9.49,而 lr=0.01 出现了发散。这些数值属于当前数据和优化设置,不是其他任务的通用推荐。
配套回归脚本默认使用 lr=0.001;其余对照结果是在固定其他条件后,分别修改优化器中的学习率运行得到的。
每次更新使用多少数据,也会影响训练:
| 方式 | 每次更新使用的样本 | 主要特点 |
|---|---|---|
| 全批量 | 全部训练样本 | 没有抽样造成的梯度波动;单次更新要处理全部数据 |
| 小批量 | 一部分样本 | 在内存、并行计算和更新频率之间折中 |
| 单样本 SGD | 一个样本 | 更新及时,但梯度抽样波动较大 |
torch.optim.SGD 不会自动决定批次大小。具体方式由输入每次梯度计算的数据,以及更新频率决定。
Dataset 组织样本与目标,DataLoader 负责分批读取。如下代码会把两个特征与对应目标一起打乱、一起取出:
from torch.utils.data import DataLoader, TensorDataset

loader = DataLoader(TensorDataset(X, y), batch_size=2, shuffle=True)

for batch_X, batch_y in loader:
    optimizer.zero_grad()
    loss = loss_fn(model(batch_X), batch_y)
    loss.backward()
    optimizer.step()
对于 3 个样本,默认保留末批时,batch_size=3 每轮更新一次,batch_size=2 每轮更新两次,batch_size=1 每轮更新三次。相同 epoch 数并不意味着相同的更新次数。
随机小批量给出的梯度是完整训练梯度的估计。换一批样本,估计方向会变化,所以损失可能上下波动。曲线平滑程度不能单独代表模型优劣。
4. 实操一:跑通线性回归训练与验证
下面用三条数据演示完整训练。数据量很小,主要用于观察参数更新。
import torch
from torch import nn

X = torch.tensor([[1., 5.], [2., 8.], [3., 15.]])
y = torch.tensor([[50.], [58.], [67.]])
X_val = torch.tensor([[2.5, 12.], [4., 20.]])
y_val = torch.tensor([[63.], [76.]])

torch.manual_seed(42)
model = nn.Linear(2, 1)
loss_fn = nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.001)

model.train()
for epoch in range(10000):
    optimizer.zero_grad()
    loss = loss_fn(model(X), y)
    loss.backward()
    optimizer.step()

model.eval()
with torch.no_grad():
    print("预测:", model(X))
    print("训练 MSE:", loss_fn(model(X), y).item())
    print("验证 MSE:", loss_fn(model(X_val), y_val).item())
该实验训练后的预测约为 [48.88, 58.11, 67.32],对应真实分数 [50, 58, 67];训练 MSE 约 0.4556,验证 MSE 约 0.1869。增加训练轮数可以在这个例子中继续改善拟合,但训练并不会自动判断到达最低点后停止。
对固定数据的线性回归与 MSE,参数空间中的损失是凸函数。损失曲面的低点对应较低损失的参数组合;训练曲线则记录实际更新过程中,各轮得到的损失。两种图的横轴含义不同。
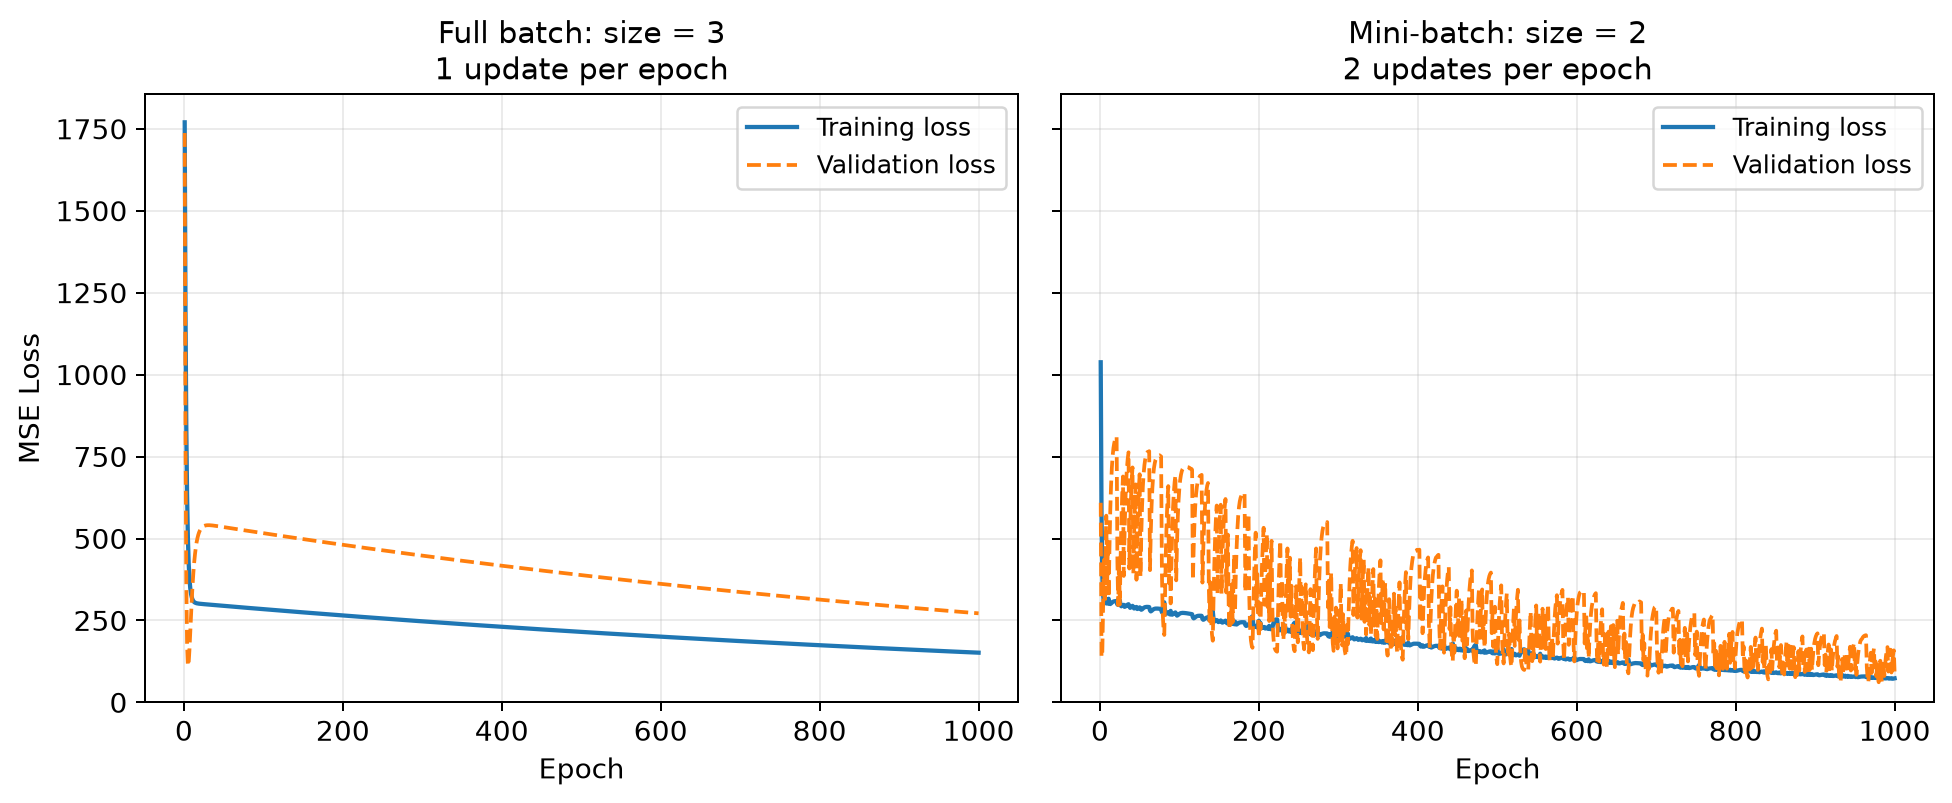
图 1:固定随机种子与 lr=0.001,分别训练 1,000 轮。左图每轮更新一次,右图每轮更新两次。该图用于观察波动与更新方式,不作为相同计算预算下的效果排名。每轮记录的训练、验证损失均由该轮更新后的同一组参数计算。
图中小批量实验只有 3 条训练数据,最后一批仅 1 条,波动尤其明显。完整脚本:线性回归与批次对照实验。
训练、验证、测试的分工
- 训练集:计算用于更新参数的损失和梯度。
- 验证集:帮助选择模型、学习率、训练轮数和分类阈值。
- 测试集:设置确定后进行独立的最终评估,不反复据其结果调参。
验证损失可以高于或低于训练损失,因为两组样本不同。观察到训练损失持续下降、验证损失持续上升时,需要检查过拟合;某一轮上升本身不能直接下结论。数据划分说明
train()、eval() 与 no_grad()
model.train() 和 model.eval() 切换模型的行为模式,本身不执行训练或验证。一些层在两种模式下行为不同,例如 Dropout 在评估时关闭随机置零。当前只含 Linear 的模型,切换模式不会改变其数值计算规则。
torch.no_grad() 控制是否记录用于反向传播的计算过程,和模式切换相互独立。评估通常同时使用 model.eval() 与 torch.no_grad()。PyTorch 官方说明
5. 逻辑回归:从数值预测转向概率
线性输出没有限制在 0~1。逻辑回归先计算原始分数 z,再使用 Sigmoid 得到正类概率:
z = w₁x₁ + w₂x₂ + b
p = 1 / (1 + exp(-z))
在 PyTorch 中,这个原始分数常称为 logit。z=0 对应概率 0.5;z 越大,概率越接近 1,越小则越接近 0。
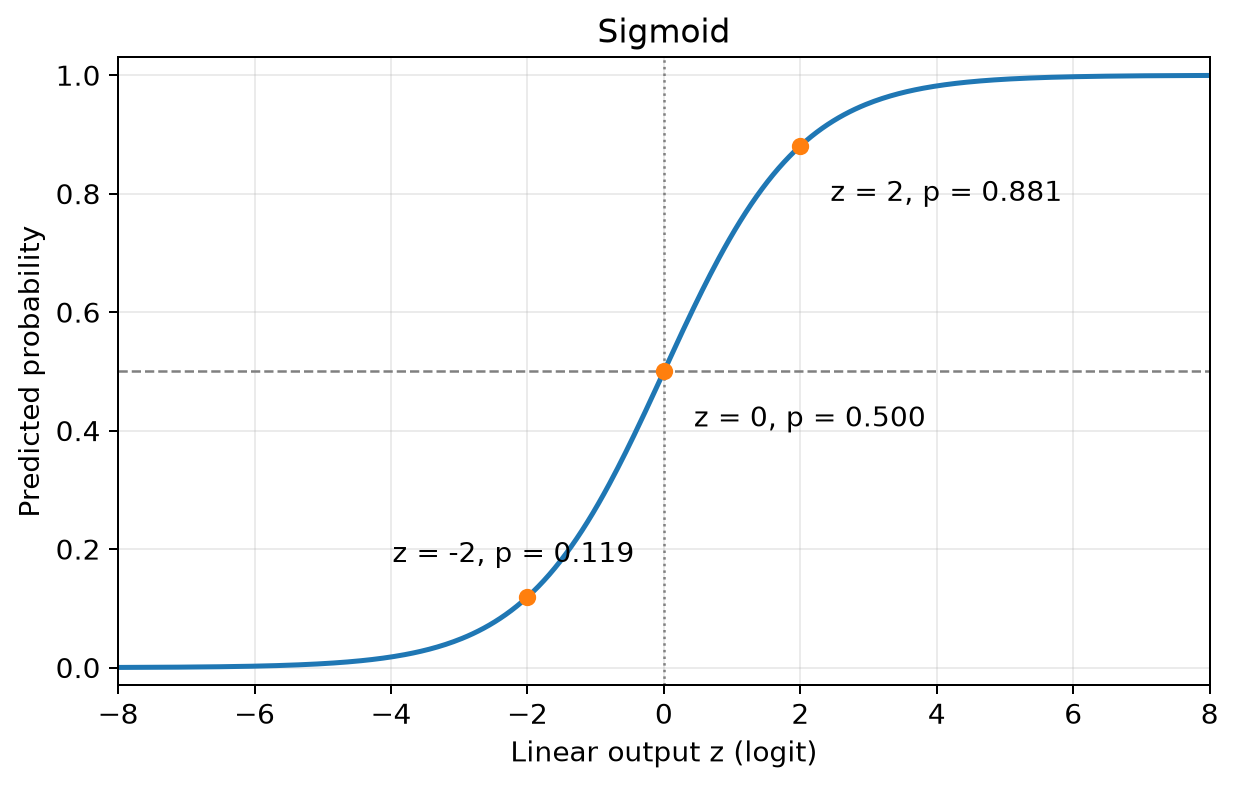
图 2:Sigmoid 的输入是原始分数,输出可解释为正类概率估计。概率为 0.8 不表示真实标签为 0.8,单个样本的标签仍然是 0 或 1。
二分类使用二元对数损失,也称二元交叉熵:
单样本损失 = -[y × log(p) + (1-y) × log(1-p)]当真实标签为 1,预测概率越接近 1,损失越小;若模型非常自信地给出接近 0 的概率,损失就很大。真实标签为 0 时则相反。
对应代码:
logits = model(X)
probabilities = torch.sigmoid(logits)

loss_fn = nn.BCEWithLogitsLoss()
loss = loss_fn(logits, y)
BCEWithLogitsLoss 内部结合了 Sigmoid 与二元交叉熵,以更稳定的方式计算。它接收原始 logits,外面计算的概率用于解释和分类决策。在本例中,目标是与 logits 同形状的浮点 0/1 张量。官方说明
正则化在本阶段只作初步理解:在拟合数据之外,对参数或模型复杂度施加约束,以帮助缓解过拟合。例如约束权重的 L1/L2 正则化,与前面用 L1/L2 度量预测误差的对象不同。当前脚本没有启用正则化,后续结合泛化与过拟合再单独实验。
6. 实操二:训练二分类模型并评估
6.1 生成用于观察分类指标的模拟样本
三条样本适合检查计算,不足以直观展示分类指标的取舍。分类实验扩展为 600 条样本,其中 480 条训练、120 条验证。
两个特征均在 0~1,模拟不同程度的学习投入和练习投入。先人为设定通过概率,再按该概率生成标签:
torch.manual_seed(42)
X_all = torch.rand(600, 2)

p_true = torch.sigmoid(6 * X_all[:, 0] + 4 * X_all[:, 1] - 5)
y_all = (torch.rand(600) < p_true).float().reshape(-1, 1)

X_train, y_train = X_all[:480], y_all[:480]
X_val, y_val = X_all[480:], y_all[480:]
这些标签在待训练模型创建之前生成,来自预设的数据生成规则。按概率生成标签保留了不确定性,因此实验中会有难以完全分开的样本。这不是关于真实学生成绩的统计结论。
训练仍沿用之前的步骤:
train_loader = DataLoader(
    TensorDataset(X_train, y_train), batch_size=32, shuffle=True
)
model = nn.Linear(2, 1)
loss_fn = nn.BCEWithLogitsLoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.1)

model.train()
for epoch in range(300):
    for batch_X, batch_y in train_loader:
        optimizer.zero_grad()
        logits = model(batch_X)
        loss = loss_fn(logits, batch_y)
        loss.backward()
        optimizer.step()

model.eval()
with torch.no_grad():
    probabilities = torch.sigmoid(model(X_val))
本例输入尺度和损失函数都与前面的回归实验不同,学习率也重新设置。不能把这里的 0.1 与回归实验中的学习率直接比较。
6.2 阈值把概率变成类别
threshold = 0.5
predicted_positive = probabilities >= threshold阈值表示判为正类所需达到的概率。0.5 是常见起点,实际选择要考虑误报与漏报的代价。改变阈值只改变类别决策,不改变模型参数、预测概率或当前交叉熵损失。
6.3 混淆矩阵与指标
规定“通过”为正类:
| 真实情况 | 预测为正 | 预测为负 |
|---|---|---|
| 实际为正 | TP:正确识别通过 | FN:漏判通过 |
| 实际为负 | FP:误判通过 | TN:正确识别未通过 |
由四种计数可以得到:
| 指标 | 公式 | 关注的问题 |
|---|---|---|
| Accuracy,准确率 | (TP + TN) / 总样本数 |
总体判断对了多少 |
| Precision,精确率 | TP / (TP + FP) |
判为正类的样本有多少真的为正 |
| Recall,召回率 | TP / (TP + FN) |
实际正类中找回了多少 |
| F1 | 2TP / (2TP + FP + FN) |
综合考虑 Precision 和 Recall |
Precision 在没有预测正类时分母为零,需要明确处理约定。配套脚本在分母为零时打印“未定义”。
PyTorch 的布尔运算可以直接完成计数:
actual_positive = y_val == 1

tp = (predicted_positive & actual_positive).sum().item()
fp = (predicted_positive & ~actual_positive).sum().item()
fn = (~predicted_positive & actual_positive).sum().item()
tn = (~predicted_positive & ~actual_positive).sum().item()
6.4 阈值实验结果
这份验证集有 57 个正类和 63 个负类,验证损失约为 0.4465。同一个模型、同一份概率,得到如下结果:
| 阈值 | TP | FP | FN | TN | 准确率 | 精确率 | 召回率 |
|---|---|---|---|---|---|---|---|
| 0.2 | 55 | 32 | 2 | 31 | 71.7% | 63.2% | 96.5% |
| 0.4 | 49 | 21 | 8 | 42 | 75.8% | 70.0% | 86.0% |
| 0.6 | 39 | 10 | 18 | 53 | 76.7% | 79.6% | 68.4% |
| 0.8 | 25 | 3 | 32 | 60 | 70.8% | 89.3% | 43.9% |
阈值降低后,更多样本被判为正类,漏判减少,同时误报增加。阈值提高则更严格。本次实验中 Precision 随阈值提高而增加,但对任意数据它并不保证严格单调;Recall 则不会因提高阈值而增加。
准确率也不随阈值单调变化。对于类别不平衡的数据,仅看准确率尤其容易误判:1,000 条样本中只有 10 条正类,全部预测为负类也有 99% 准确率,但 Recall 为 0。
6.5 ROC 与 AUC
ROC 用不同阈值下的两个比例作为坐标:
横轴 FPR = FP / (FP + TN)
纵轴 TPR = TP / (TP + FN) = Recall
每个阈值对应一个点。降低阈值,通常会召回更多正类,也带来更多误报;图中的点因此向右上方向移动。
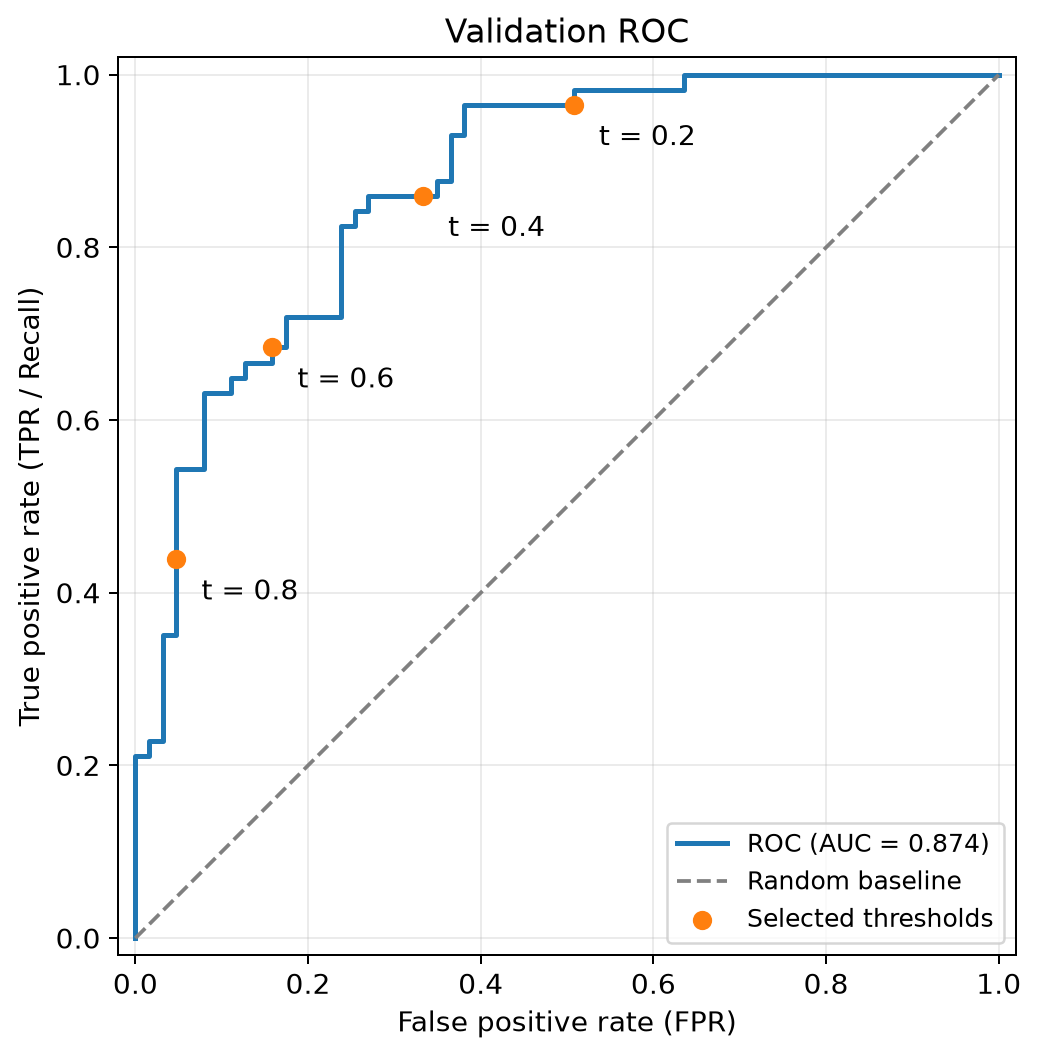
图 3:曲线来自验证集中所有不同预测概率及起点阈值,橙点标出四个展示阈值。AUC 约为 0.874,是该模拟验证集的结果。
灰色对角线表示没有排序区分能力时的参考情况。AUC 是 ROC 下方的面积,用于概括模型对正负类的排序区分能力,不表示准确率为 87.4%,也不直接给出最终该选的阈值。
在相同 FPR 下,TPR 越高通常越好,因此 ROC 越靠近左上角,整体区分能力通常越强。具体使用哪个点,仍取决于任务对误报和漏报的要求。
这里没有只连接四个橙点计算面积,而是扫描全部不同预测分数。经验 ROC 呈阶梯状很正常:验证集只有有限个样本,阈值跨过某个样本分数时,计数才会变化。增加验证样本可能让阶梯更细,仅增加重复阈值不会增加有效信息。
完整代码:逻辑回归、阈值指标与 ROC 练习。
6.6 两个初步了解的延伸
预测偏差比较平均预测概率与实际正类比例:
预测偏差 = 平均预测概率 - 平均真实标签它反映整体概率预测是否偏高或偏低,与线性公式中的偏置 b 不同。预测偏差为零,也不能单独证明每个样本都预测准确。课程说明
多类别分类需要在多个互斥类别中作选择。输出可以是每个样本的 C 个 logits;在 PyTorch 中,常用 nn.Linear(d, C) 配合 nn.CrossEntropyLoss。常见单标签用法中,损失函数直接接收 logits 与整数类别索引。本文实操先完成二分类,多分类留待后续单独练习。
7. 学习中需要分清的几组概念
| 容易混淆的内容 | 需要区分的地方 |
|---|---|
| 模型、预测结果 | 模型带参数和计算规则,预测结果是一次计算得到的张量 |
| 残差、损失、梯度 | 分别描述偏离方向、误差评分、参数变化对损失的影响 |
backward()、step() |
前者计算梯度,后者更新参数 |
| 清梯度、清参数 | zero_grad() 清理梯度记录,不把权重清零 |
eval()、no_grad() |
前者切换行为模式,后者控制梯度记录 |
| epoch、参数更新次数 | 一轮可以包含多个批次和多次更新 |
| 概率、阈值、类别 | 概率是模型输出的估计,阈值是决策规则,类别是决策结果 |
| AUC、准确率 | 一个概括排序区分能力,一个衡量给定决策下的正确比例 |
当前分类实验划分了训练集和验证集,没有独立测试集。阈值与训练设置已在验证集上比较,因此文中的指标都标为验证结果。正式评价时,应在设置确定后,用独立测试集再检查一次。
8. 阶段小结与后续学习
这一阶段已经把一条基本流程连接起来:
准备特征与目标 → 创建模型 → 前向计算 → 损失
    → 反向求导 → 优化器更新 → 验证 → 阈值与指标
对我而言,主要收获是理解了这些步骤怎样相互连接。函数的参数细节仍需要按需查文档,尤其关注输入输出、张量形状、是否修改原对象,以及操作发生在训练还是评估阶段。
下一阶段继续学习数值数据处理、归一化与标准化、数据泄漏、泛化和过拟合,再补充正则化与多分类实验。特征缩放涉及的统计量应只从训练集估计,再应用到验证集、测试集和新数据。
配套代码与复现
完整脚本依赖 torch 和 matplotlib,使用模拟数据,固定随机种子并在 CPU 上运行。
本次运行环境为 Python 3.12.14、PyTorch 2.14.1、Matplotlib 3.11.2;其他版本或设备上的结果可能存在细微数值差异。
配套文件可从完整实验包(ZIP)下载。解压后保留 code/ 与 images/ 同级的目录结构,在解压目录运行下面的命令;单个脚本也可通过前文链接查看或另存为文件。
python code/linear_regression_demo.py
python code/binary_classification_demo.py
脚本会在 images/ 中保存配图,并显示图窗。正文中的代码是用于解释核心步骤的片段,完整的数据准备、训练和绘图以配套脚本为准。
参考资料
- Google Machine Learning Crash Course:线性回归
- Google Machine Learning Crash Course:逻辑回归
- Google Machine Learning Crash Course:分类
- Google:训练集、验证集与测试集
- PyTorch:基础教程
- PyTorch:自动求导
- PyTorch:BCEWithLogitsLoss
学习记录整理日期:2026-11-13。课程概念以个人理解重新表述;实验代码、数据和配图用于教学演示。